

Ewaluacja Nemotron-3-Diarization na SpokesBiz i DiaBiz
 Autor: VoicelabVoiceLab
Nowy model diaryzacji mówców od Nvidii wygląda naprawdę solidnie. W Voicelab właśnie przetestowaliśmy go na wielomówcowym zbiorze danych SpokesBiz (650 godzin) i wygląda na to, że jest zarówno dokładniejszy, jak i szybszy od Sortformer v2 od Nvidii oraz PyAnnote 3.1. Wyniki na dwumówcowym, telefonicznym zbiorze DiaBiz (410 godzin) są bardziej zniuansowane - oba modele Nvidii wyraźnie przewyższają tam Pyannote 3.1.
Ewaluacja na SpokesBiz
SpokesBiz (Pęzik i in. 2023) to korpus konwersacyjnej polszczyzny z pelcra.pl (Uniwersytet Łódzki), obejmujący ponad 650 godzin w 925 nagraniach (59 rozmów z udziałem 1 mówcy, 631 z udziałem dwóch mówców, 222 z udziałem 3, 12 z udziałem 4 i zaledwie 1 z udziałem 5 mówców), w całości ręcznie transkrybowanych i zdiaryzowanych.
Ogólne wskaźniki błędu diaryzacji (DER) oraz błędu diaryzacji na poziomie słów (WDER) wskazują Nemotron-3 jako zdecydowanego zwycięzcę. Metrykę DER trudniej rzetelnie porównywać niż WDER (zob. https://arxiv.org/pdf/1907.05337), ponieważ mierzy ona dokładny procent czasu, w którym fragment mowy (lub ciszy) został przypisany niewłaściwemu mówcy. Jej dokładna wartość zależy od jakości wymuszonego dopasowania (forced alignment), dlatego co do zasady preferujemy wskaźniki błędu przypisania na poziomie słów jako bardziej intuicyjną miarę w zastosowaniach diaryzacji, w których chcemy przypisać transkrybowane słowa mówcom. Wyniki dla SpokesBiz podsumowuje Tabela 1. W tym eksperymencie segment modelu musiał pokrywać się ze znacznikiem czasu słowa referencyjnego w co najmniej 50%, aby uznać go za dopasowanie.
| Model | DER | WDER | xRT |
|---|---|---|---|
| nvidia/Nemotron-3-Diarization | 22.5% | 4.8% | 0.0022 |
| nvidia/diar_streaming_sortformer_4spk-v2 | 23.4% | 7.4% | 0.0027 |
| pyannote/speaker-diarization-3.1 | 24.4% | 8.3% | 0.0078 |
Tabela 1. Wyniki DER i WDER na SpokesBiz
Kolejną interesującą obserwacją jest odsetek przeszacowań i niedoszacowań liczby mówców. Także tutaj, jak pokazuje Tabela 2, Nemotron-3 jest znacznie dokładniejszy od pozostałych dwóch modeli - trafność przewidywania liczby mówców przekracza u niego 80% (>80%). Popularny model Pyannote 3.1 przeszacował liczbę mówców w ponad 75% przypadków na SpokesBiz. Ogólnie rzecz biorąc, wszystkie trzy modele, gdy już się mylą, częściej przeszacowują niż niedoszacowują liczbę mówców.
| Model | Dokładnie tyle, ile trzeba | Za dużo mówców | Za mało mówców |
|---|---|---|---|
| Nemotron | 80.6% | 19.1% | 0.2% |
| Sortformer v2 | 51.7% | 48.1% | 0.2% |
| pyannote 3.1 | 23.1% | 75.9% | 1.0% |
Tabela 2. Przewidywana liczba mówców w porównaniu z liczbą referencyjną na SpokesBiz
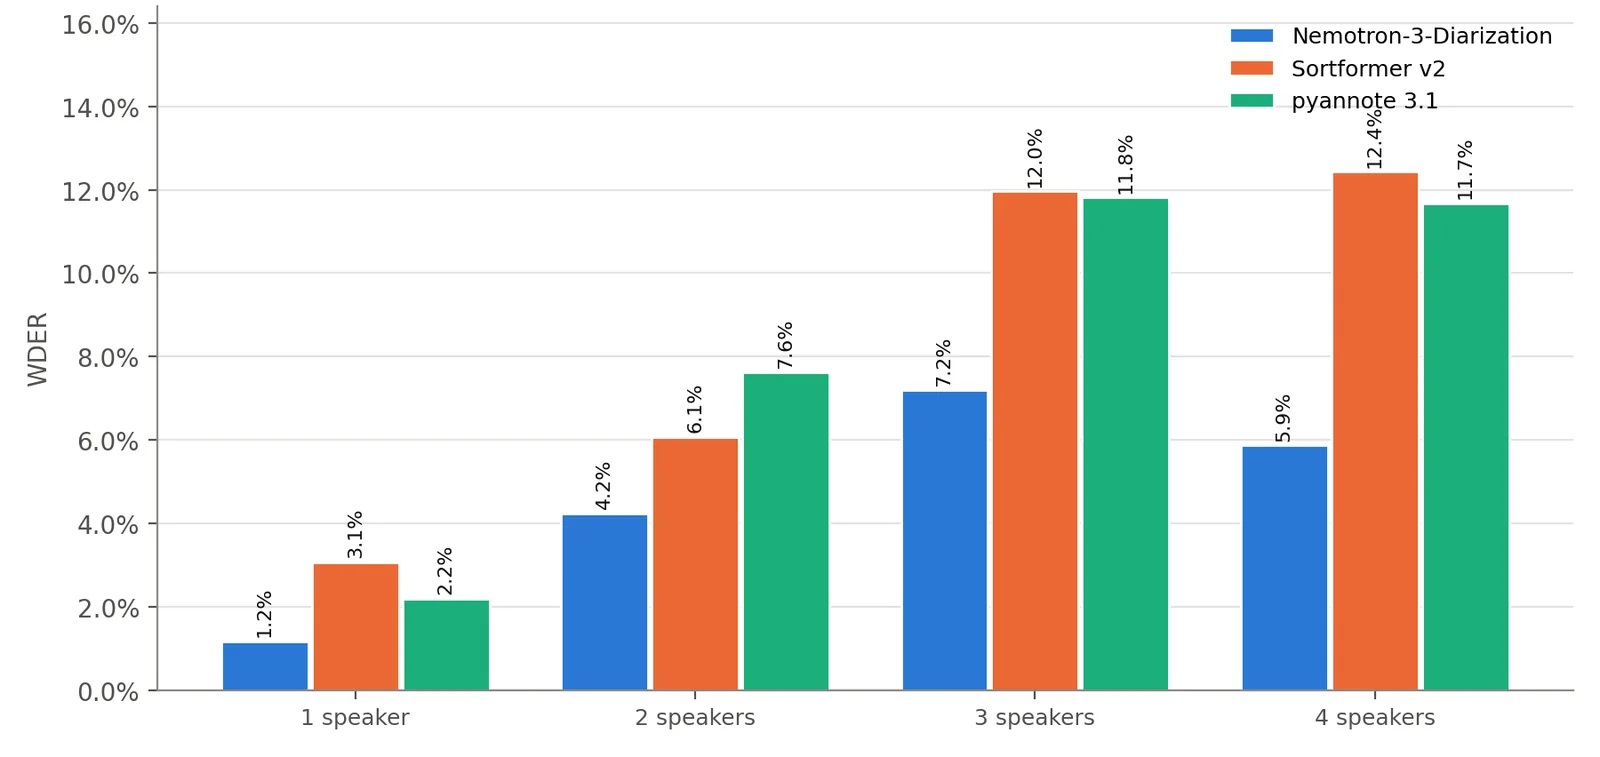
Rys. 1. Średni WDER na SpokesBiz według referencyjnej liczby mówców
Ewaluacja na DiaBiz
DiaBiz (Pęzik i in. 2020) to kolejna baza danych mowy z Uniwersytetu Łódzkiego - korpus dialogowy obejmujący nagrania i oznaczone transkrypcje telefonicznych rozmów klientów z konsultantami w kilku kluczowych dziedzinach biznesowych (np. bankowość, motoryzacja, wynajem, opieka medyczna, ubezpieczenia, windykacja, turystyka itp.). Oryginalne nagrania są stereofoniczne. Na potrzeby tego eksperymentu zmiksowaliśmy kanały konsultanta i klienta oraz przyjęliśmy, że w każdym nagraniu zawsze występuje dwóch mówców. Jak pokazuje Tabela 3, nemotron-3-diarization ma najniższy średni WDER na DiaBiz.
| Model | DER | WDER | xRT |
|---|---|---|---|
| nvidia/Nemotron-3-Diarization | 23.3% | 6.3% | 0.0020 |
| nvidia/diar_streaming_sortformer_4spk-v2 | 22.8% | 7.4% | 0.0028 |
| pyannote/speaker-diarization-3.1 | 28.3% | 12.3% | 0.0082 |
Tabela 3. Wyniki DER i WDER na DiaBiz
Wydaje się jednak, że w tym zbiorze rozmów konsultantów z klientami to Sortformer V2 częściej trafiał z liczbą mówców. Warto zauważyć, że niektóre modele mogą mieć wbudowaną skłonność do przewidywania dokładnie dwóch mówców jako bezpiecznej wartości domyślnej.
| Model | Dokładnie tyle, ile trzeba | Za dużo mówców | Za mało mówców |
|---|---|---|---|
| Nemotron-3 | 90.8% | 9.2% | 0.0% |
| Sortformer v2 | 94.5% | 5.3% | 0.1% |
| pyannote 3.1 | 70.8% | 29.0% | 0.2% |
Tabela 4. Przewidywana liczba mówców w porównaniu z liczbą referencyjną na DiaBiz
Obecnie testujemy ten model na językach innych niż polski oraz w różnych scenariuszach ASR.
Autorzy: Piotr Pęzik, Aleksandra Nadzieja, Filip Żarnecki, Wojciech Janowski, Kryspin Musioł, Paweł Czerkas, Anna Dryżałowska, Jacek Kawalec, Andrzej Ciarkowski